把家里的算力全掏出来:WeKnora 的模型保障线实录
WeKnora 跑在家庭虚拟机上,承担家里和公司两套知识库,有三类模型调用:文档解析、向量嵌入、摘要生成。早期全走公网 API,两个月后两个问题都到了忍不了的程度:成本,和”文档内容出境”这件事本身。真正花时间的不是选模型,是家里没有一台”够用的机器”,只有几台”各管一段的机器”。
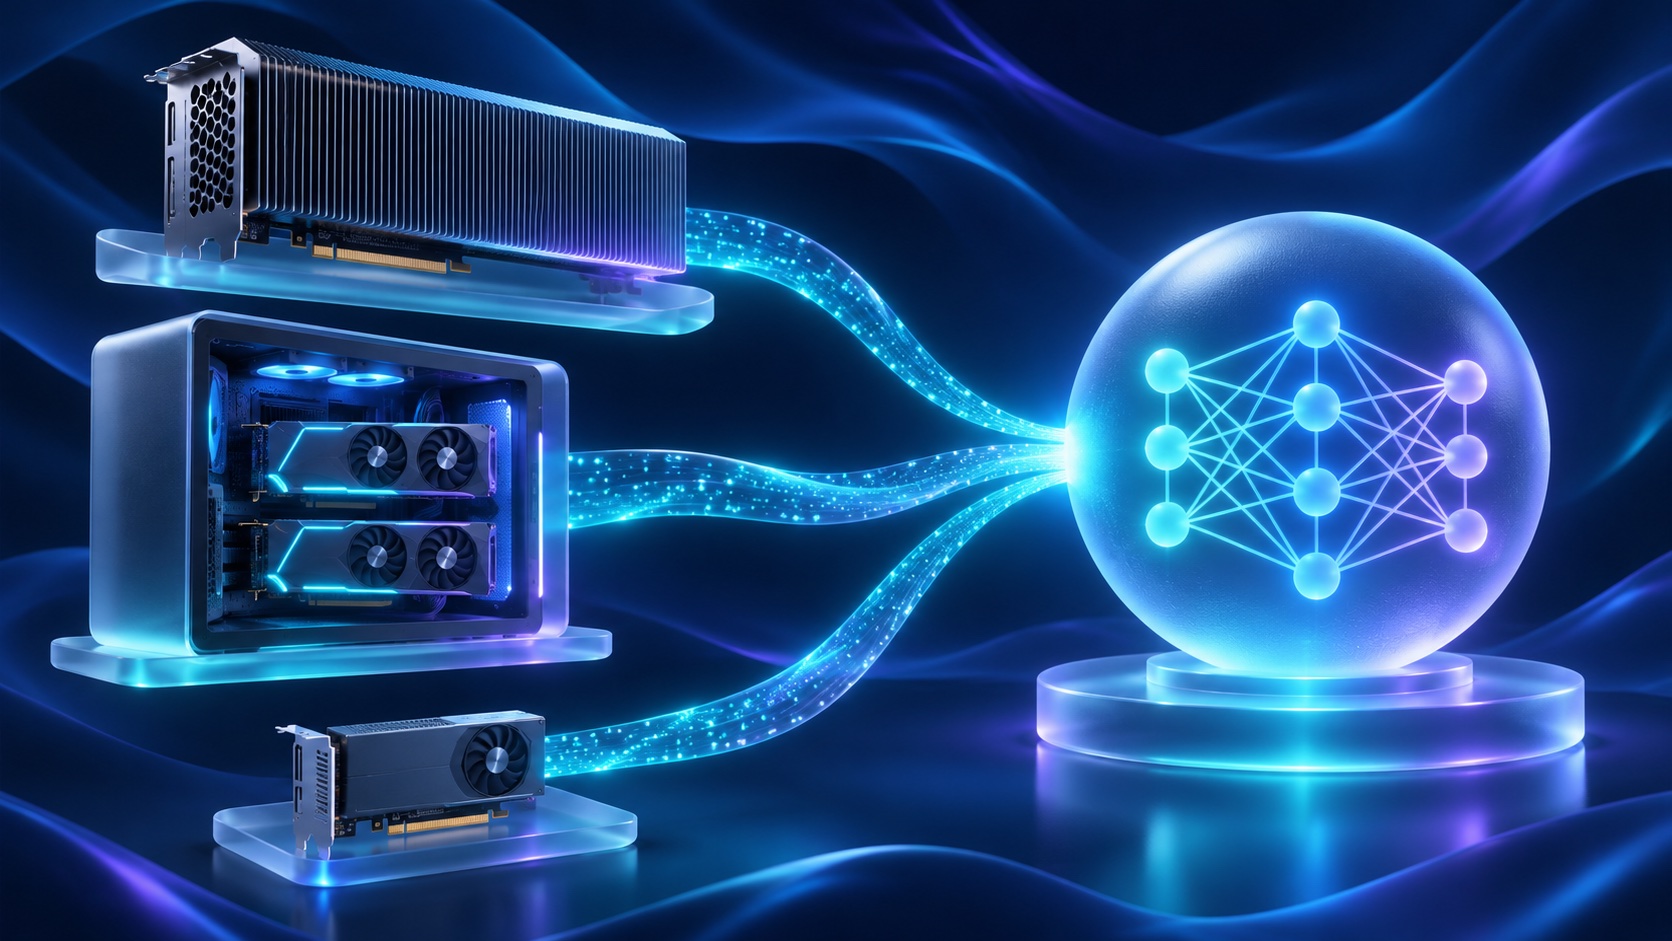
家底盘点:没有一台够,拼起来才够
| 节点 | GPU | 用途起点 | 接入 WeKnora 后的角色 |
|---|---|---|---|
| 飞牛 NAS | Tesla P100 16G(无风扇) | 视频处理 | 嵌入 + 短文本解析池 |
| 主力台式机 | 双卡 | 游戏 + 本地实验 | 长/短上下文对话池(GGUF 模型) |
| Mac mini | Apple Silicon 统一内存 | CI runner | 嵌入回退池 |
| DGX Spark | GB10 121G 统一内存 | 256K 长上下文 | 大模型主力(单列一篇) |
四台全是既有用途。池化方案是加一个轻量推理路由(下称 router):WeKnora 只对着 router 单一端点发请求,router 按角色(短对话/长对话/嵌入/摘要)分发到对应池子——把供给复杂度收敛在一层,调用方只认一个地址,供给侧随便折腾。
路由层:一个熔断口径管全部池子
每个池子五个固定字段:active / capacity / waiting / success / failure,外加状态位 circuit_open。判定规则:
- 连续失败超阈值 →
circuit_open=true,摘流; - 摘流 30 秒后由真实请求自然回流——不额外造探活请求,第一个真实请求就是探针,成功即清零;
- 回退有两条不同的路:熔断或上下文预算不足时沿候选链换池(静态回退);排队超时直接 429 让 WeKnora 退避重试(动态退避),不无限堆。
口径都是代码里的落点。池子的熔断状态机:
1 | class Pool: |
open_until 时间戳挂在请求释放路径上:熔断窗口内进来的请求直接 503,30 秒后自然放行,放行的第一个成功请求把状态清零。“摘流→等待→自然回流”两个字段(失败计数 + 截止时间)就实现了,不需要半开状态机,也不需要探测定时器——探活不额外造请求,借的是业务流量本身。
归因的底座是每请求一行结构化日志(归因字段是踩坑后补的):
1 | {"request_id":"9f4567a6…","backend":"long","group":"…","ok":false, |
request_id 贯穿,backend/group 定位池与知识库,stage 区分卡在排队还是卡在上游——/metrics 的瞬时状态加逐请求日志就是完整时间线。
两次实际熔断,两种性质,都记下来:
P100 池被视频任务挤掉。 P100 白天在给 NAS 的视频处理出图,显存占满,嵌入请求全超时,router 两分钟内熔断摘流,请求自动落到 Mac mini 回退池。WeKnora 侧只看到”部分解析变慢”,没有失败。这就是熔断层存在的意义:把”常态争抢”从”故障”里分出来。
分发侧的”按角色路由”在代码里是角色 → 主池 + 候选回退链:
1 | def resolve(body, headers, path): |
候选先查熔断,再按真实 tokenizer 计数核对上下文窗口(不是按字符估)。超限不直接失败,而是换链上下一个池子——长文进不了 short 池自然落到 long 池。所以准确说法是:角色定主池,熔断状态和上下文预算定实际落点;两条回退路径在此汇合,互不干扰。
台式机池被游戏抢占。 手动策略而非熔断:打补丁/玩游戏前跑”暂停序列”——router 配置层摘除该池后端(对已摘除后端 503 转回退);Windows 侧 WinRM 停两个模型服务、杀进程、确认两卡占用归零。恢复顺序反过来:先起模型、验证端点真实能出 token,再恢复 router 配置。先验证后端、再放开路由——顺序反了就是把半死的服务挂回流量。
P100 池:显存 16G 是硬约束,两边都常驻必爆
P100 16G 同时供嵌入和视频处理,分配原则写死:嵌入模型常驻(几个 GB 级)优先保;视频出图模型按需加载、用完即卸——两边都常驻峰值超 16G,视频侧的代价是每次出图多等十几秒加载。
反直觉的地方是被让路的反而是新业务:嵌入是 WeKnora 的调用主力,视频出图是低频次任务——按调用频次定驻留优先级,不按业务新旧。更细的显存记录见飞牛 app 那篇。
嵌入:最高频、最便宜、最敏感,必须单池
嵌入调用频率最高(每次文档进出都打)、单次最便宜、对延迟最敏感,两条教训:不和大对话同池——一个大请求的排队会把几十个小嵌入请求全卡住;Mac mini 回退池容量按”主池全挂时 24 小时能消化当前积压”算,不按峰值算——峰值永远补不满,积压消化才是现实目标。
供给线全景
1 | WeKnora |
配置层面的证据:三库所有模型槽位(摘要/Wiki 合成/问答/嵌入等,逻辑模型名)的 base_url 只有一条 http://inference-router:8080/v1,宿主侧映射 18093 [等价实现]。槽位里看不到”池”的存在——切本地那天改的是槽位的 base_url 和模型名,不是加一堆后端地址。“调用方只认一个地址”落到实处就是这一条 base_url。 踩过坑:配置是容器挂载卷,改完必须 force-recreate 才生效,忘重建就一直没加载。
成果:供给线已收敛到单一端点,且按设计扛过真实争抢
- 调用侧收敛完成:WeKnora 的模型调用从”全走公网 API”收敛到只对着 router 单一端点 18093 发请求,四个池子各就各位,后端怎么换都不动它的配置。
- 两套原始动机的现状:成本与文档出境不再是”忍不了”——供给主体已换成家里算力(P100、台式机、Mac mini、DGX Spark),端点不变。
- 熔断口径不是纸面设计:两次真实争抢都按设计行为走了,WeKnora 侧都无失败。
- 归因链路已验证:逐请求结构化日志 +
/metrics五字段 + 状态位,哪个池子慢、当时熔断状态如何直接读;加机器只是填表,新节点按五字段接入。
未闭环清单
| 事项 | 状态 |
|---|---|
| router 单点(与知识库同 VM,VM 重启期间供给线全断) | 未闭环,独立部署 + 状态外置已列待办 |
| router 配置靠容器重建生效(改配置忘 recreate 不加载) | 已踩坑,未闭环:配置热加载或改后校验 |
| 游戏暂停序列 | 手动策略,未自动触发 |
| Mac mini 回退池积压消化时长的真实值 | 按 24 小时口径设计,未实测压满 |
小结
拼供给线没有高难动作:四台异构机器、一个 router、一套熔断口径。真正花时间在取舍上:P100 显存归谁、嵌入池独立与否、回退容量按峰值还是按积压、暂停与恢复的顺序。
只留一条经验:多机拼推理池,先定熔断口径再定池子——口径统一了,加机器只是填表。
文中卡型、显存、端口取自当时现场记录;公司名与内网地址已脱敏,未闭环项以表格为准。